Quando a IA entende a ação, mas não a intenção
Uma pessoa pega uma xícara. O que ela pretende fazer?
Beber água? Entregar a xícara para alguém? Colocá-la em outro lugar?
Para um sistema de inteligência artificial que tenta interpretar o comportamento humano, uma mesma ação pode esconder objetivos completamente diferentes. O problema também funciona no sentido contrário: uma mesma intenção pode ser alcançada por vários caminhos.
É justamente essa ambiguidade entre objetivo e ação que pesquisadores do Korea Advanced Institute of Science and Technology (KAIST), em colaboração com a Microsoft Research Asia, tentaram enfrentar.
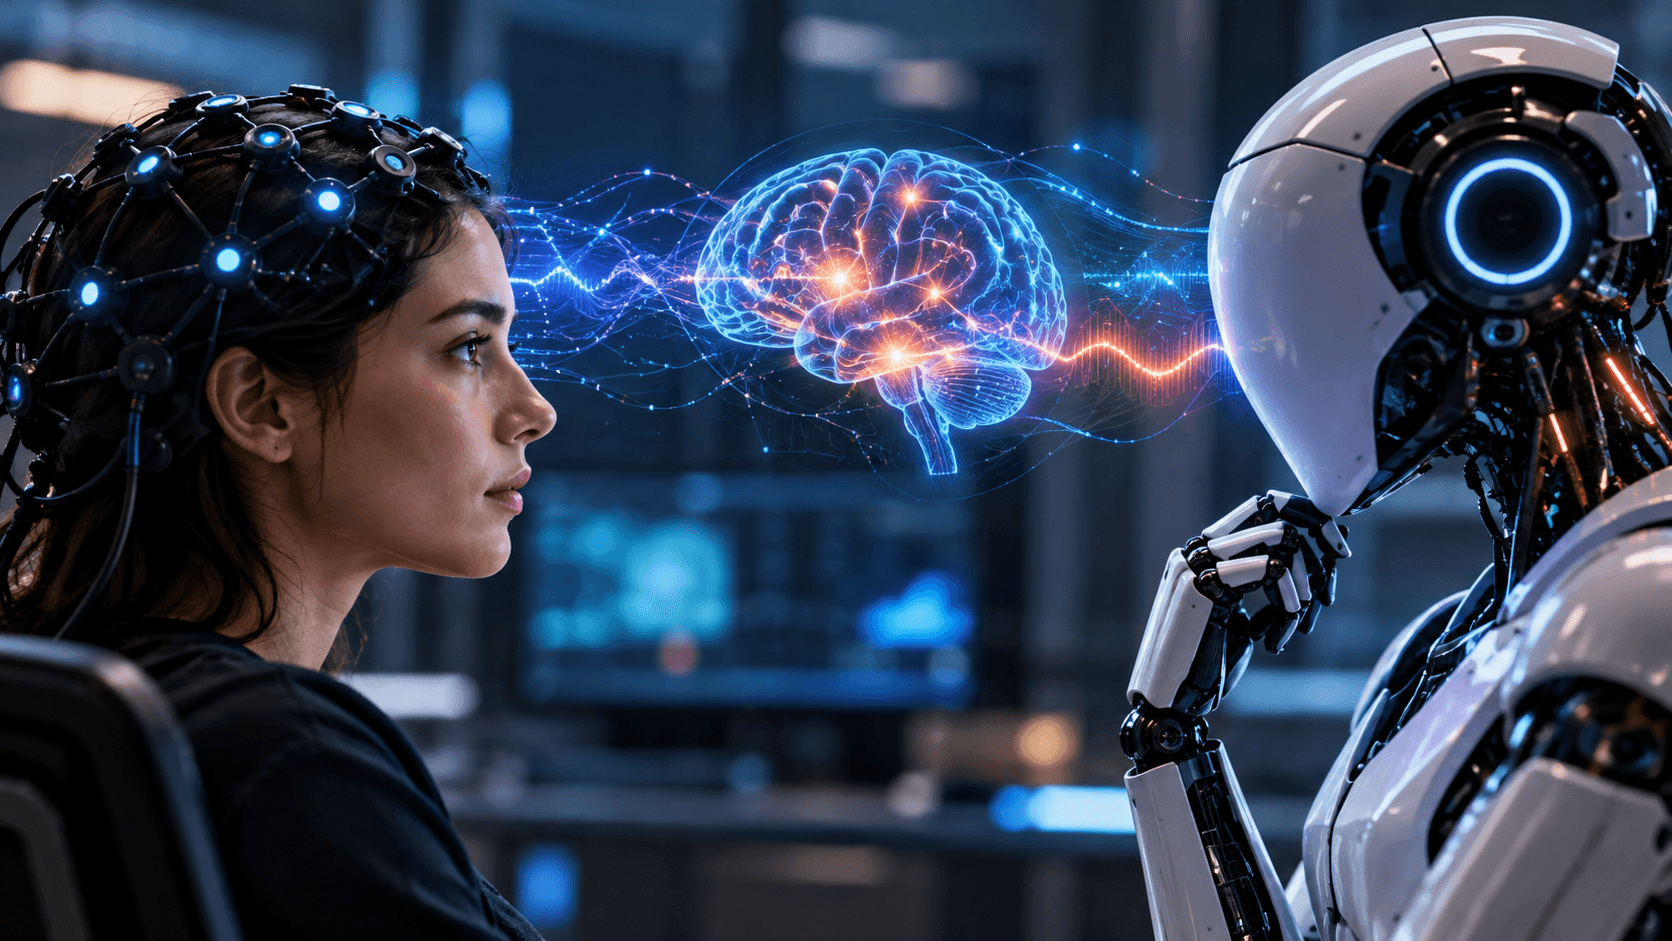
O resultado é uma abordagem chamada Neural Value Alignment (NVA), capaz de utilizar sinais cerebrais para identificar quando existe uma discrepância entre aquilo que a IA está fazendo e aquilo que a pessoa pretendia.
A ideia é detectar o “isso não era o que eu quis dizer” antes que ele seja verbalizado.
O cérebro pode revelar que algo deu errado
A pesquisa parte de uma característica conhecida da atividade cerebral: quando algo acontece de maneira diferente do esperado, o cérebro produz sinais associados a erros de previsão.
Os pesquisadores concentraram-se em dois tipos de resposta.
O primeiro é o Reward Prediction Error (RPE), ou erro de previsão de recompensa. Nesse contexto, ele está relacionado a uma situação em que a IA interpretou incorretamente o objetivo final da pessoa.
O segundo é o State Prediction Error (SPE), ou erro de previsão de estado. Nesse caso, a IA entendeu o objetivo, mas escolheu um método ou caminho diferente daquele que a pessoa esperava.
A distinção é importante.
Imagine alguém querendo beber água. Se um robô entrega café, o problema está no objetivo compreendido pela máquina. Já se o robô entende que a pessoa quer água, mas escolhe um caminho inesperado para buscá-la, o objetivo pode estar correto enquanto a estratégia está errada.
Para um sistema convencional, ambas as situações podem simplesmente parecer uma resposta negativa.
Para o NVA, elas representam problemas diferentes.
EEG transforma a reação cerebral em informação para a IA
Para investigar essas diferenças, os pesquisadores utilizaram eletroencefalografia (EEG) para registrar a atividade elétrica cerebral enquanto participantes observavam sistemas de IA executando tarefas.
Os experimentos mostraram padrões distintos associados aos sinais de RPE e SPE, além de respostas relacionadas à ocorrência simultânea dos dois tipos de erro.
A equipe então utilizou técnicas de aprendizado profundo para decodificar esses sinais.
O objetivo não é transformar pensamentos em texto.
A IA não precisa saber exatamente o que a pessoa está pensando. Ela precisa identificar que existe uma incompatibilidade entre sua interpretação e a resposta cerebral do usuário.
Essa diferença muda completamente a proposta.
Em vez de depender exclusivamente de comandos adicionais como “não foi isso”, “faça de outro jeito” ou “eu queria outra coisa”, o sistema poderia utilizar o feedback neural como uma nova camada de comunicação entre humano e máquina.

O objetivo está errado ou apenas o caminho?
Essa é a principal contribuição conceitual do trabalho.
O NVA tenta separar dois problemas que normalmente ficam misturados durante uma interação humano-IA.
Se o sistema identifica um SPE, a interpretação é que o objetivo está correto, mas a estratégia escolhida precisa ser modificada.
Se identifica um RPE, a conclusão é diferente: a própria interpretação do objetivo precisa ser revista.
Essa distinção permite que o sistema adapte seu comportamento de maneira mais direcionada.
Em vez de simplesmente tentar novamente, a IA pode determinar o que precisa ser corrigido.
O estudo publicado no IEEE Transactions on Cybernetics descreve justamente essa combinação entre RPE e SPE como uma forma de tornar o alinhamento entre humanos e IA mais flexível diante da ambiguidade entre objetivos e ações. :chatgpt-content-reference{index="1"}
De comandos explícitos para sinais implícitos
Grande parte da interação atual com sistemas de IA depende de informação explicitamente fornecida pelo usuário.
Se um assistente interpreta uma solicitação de maneira incorreta, a pessoa precisa corrigir o sistema. Se um robô executa uma tarefa de maneira inadequada, normalmente é necessário fornecer outra instrução.
O NVA aponta para uma direção diferente: permitir que a máquina também considere sinais implícitos produzidos pelo cérebro durante a interação.
Essa mudança pode parecer pequena, mas representa uma diferença importante na arquitetura da interação.
A IA deixaria de observar apenas aquilo que a pessoa fala ou faz e passaria a considerar também uma resposta neural associada à avaliação daquela ação.
O próximo passo da IA pode não ser apenas entender o que dizemos, mas perceber quando sua própria interpretação está errada.
Robôs podem ser um dos principais destinos
Os pesquisadores enxergam aplicações potenciais em sistemas que precisam colaborar diretamente com seres humanos.
Robôs domésticos poderiam utilizar esse tipo de feedback para ajustar suas ações quando interpretassem uma tarefa de maneira inadequada.
Em ambientes industriais, a tecnologia poderia ajudar sistemas robóticos a se adaptar às preferências e decisões humanas. Também existem possibilidades em veículos autônomos, sistemas de reabilitação, tecnologias assistivas e ferramentas educacionais.
Em pessoas com dificuldades para falar ou se movimentar, por exemplo, interfaces cérebro-computador podem abrir possibilidades de comunicação e controle que dependam menos de comandos tradicionais.
O próprio laboratório responsável pelo trabalho pesquisa a integração entre neurociência, aprendizado de máquina, EEG e sistemas de inteligência artificial. :chatgpt-content-reference{index="2"}
Ainda estamos longe de uma IA que lê pensamentos
Apesar do impacto do conceito, é importante separar a pesquisa do imaginário popular sobre “leitura mental”.
O trabalho não demonstra uma IA capaz de acessar livremente os pensamentos de uma pessoa.
O sistema utiliza sinais obtidos por EEG, dentro de uma configuração experimental, e procura identificar padrões relacionados à resposta humana diante do comportamento da IA.
Além disso, os resultados descritos pelos pesquisadores incluem simulações que mostram ganhos de adaptação mesmo em condições de incerteza. Isso não significa que um robô doméstico já consiga acompanhar continuamente a atividade cerebral de uma pessoa em uma casa e corrigir autonomamente qualquer comportamento inadequado.
Ainda existem desafios técnicos importantes para levar esse tipo de sistema para ambientes naturais, onde movimento, ruído e variações individuais tornam a interpretação dos sinais cerebrais muito mais complexa.
Uma nova camada para o alinhamento entre humanos e IA
O interesse do Neural Value Alignment está justamente em atacar um dos problemas centrais da colaboração entre humanos e máquinas: uma ação observável nem sempre revela a intenção que está por trás dela.
Durante décadas, sistemas computacionais foram construídos para interpretar comandos, ações e resultados.
A proposta apresentada pelo KAIST e pela Microsoft Research Asia adiciona uma camada diferente: observar a resposta neural produzida quando o comportamento da máquina não corresponde ao que o humano esperava.
Isso não significa que a IA esteja adquirindo consciência ou passando a “ler a mente” das pessoas.
Significa algo mais específico — e potencialmente mais importante para a engenharia de sistemas inteligentes:
a máquina pode começar a usar o cérebro humano como uma fonte adicional de feedback para descobrir quando sua própria interpretação falhou.
Se essa abordagem evoluir para interfaces mais robustas e naturais, a relação entre pessoas, robôs e sistemas de IA poderá deixar de depender exclusivamente daquilo que conseguimos dizer ou demonstrar.
E, nesse cenário, talvez o próximo salto da interação humano-máquina não seja ensinar a IA a obedecer melhor.